

Amazon RDS: tutta la potenza di PostgreSQL, senza il lavoro notturno
Articolo di Gaia Pistori – Full-stack Developer in AzzurroDigitale
Nella scorsa puntata abbiamo parlato di EC2, il mattone su cui poggia buona parte del cloud. Ma una volta che le istanze sono su e funzionanti, arriva subito la domanda successiva: dove metto i dati? Potreste installare PostgreSQL o MySQL, i due database più diffusi, su una EC2 e occuparvene voi, con i backup, le copie di sicurezza e la manutenzione che ne conseguono. Oppure potete lasciare ad AWS la parte noiosa. È qui che entra in gioco Amazon RDS (Relational Database Service). In questo episodio vediamo cosa cambia davvero nel lavoro di tutti i giorni, spiegando i termini tecnici man mano che li incontriamo.
Cosa vuol dire davvero “managed”
“Managed” (gestito) non è solo una parola da brochure. Vuol dire che AWS si prende un bel pezzo di lavoro operativo, di quello che richiede tempo e competenze specifiche. Ecco cosa include, in concreto:
- Backup automatici: ogni giorno AWS crea una copia di sicurezza completa del database (uno “snapshot”) e la conserva fino a 35 giorni. Potete anche tornare a un istante preciso nel passato. È comodissimo se qualcuno cancella per sbaglio dei dati alle 14:32 di un martedì, e non serve scrivere nessuno script.
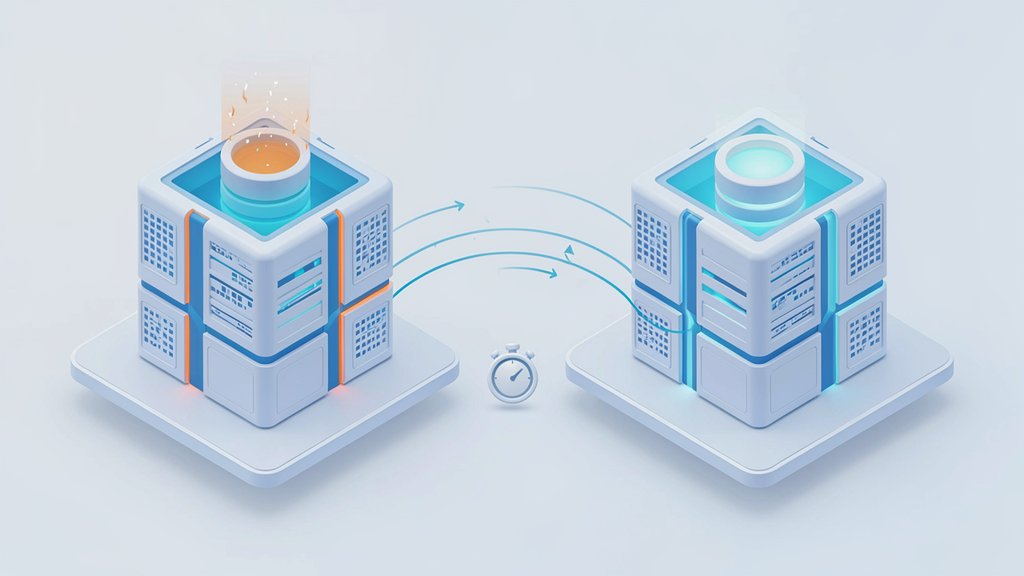
- Failover automatico: con l’opzione Multi-AZ (AZ sta per Availability Zone, un data center fisicamente separato ma vicino), RDS tiene una copia sincronizzata del database in un’altra zona. Se quello principale smette di funzionare, la copia prende il suo posto in 60-120 secondi, senza che nessuno debba svegliarsi nel cuore della notte.
- Patching: gli aggiornamenti di sicurezza li applica AWS, in una fascia oraria scelta da voi, così non avrete sorprese durante l’orario di lavoro.
- Monitoring integrato: carico del processore, velocità del disco (le IOPS, cioè le operazioni al secondo che il disco riesce a gestire) e connessioni attive sono già visibili in un pannello dedicato, senza installare niente.
- Spazio disco che cresce da solo: se il database si avvicina al limite, lo spazio aumenta in automatico, senza fermare il servizio.
Il punto non è che gestire un database da soli sia impossibile. È che rifare tutto questo a mano richiede tempo, competenze e manutenzione continua. RDS non vi toglie il compito di controllare che l’applicazione funzioni bene, ma vi leva dalle spalle l’80% delle operazioni ripetitive e a basso valore aggiunto.
Gestito, ma non per questo meno flessibile
Un dubbio comune è questo: se è AWS a occuparsi di tutto, quanto margine di personalizzazione mi resta? Molto più di quanto si pensi. Il database (o i database, se il progetto ne richiede più d’uno) creato su RDS è un motore “vero”, estensioni comprese.
Prendiamo PostgreSQL, che tra i motori supportati da RDS ha l’ecosistema di estensioni più ricco. Se vi serve la ricerca per similarità, utile nelle applicazioni con intelligenza artificiale (pensate a chatbot con memoria o a sistemi di raccomandazione), potete aggiungere pgvector. Introduce un tipo di dato dedicato ai vettori e permette di fare ricerche di similarità direttamente con query SQL, senza tenere in piedi un database separato solo per quello. Se invece lavorate con dati geografici, come mappe, percorsi o aree di copertura, c’è PostGIS, che aggiunge funzioni e tipi di dato pensati per l’analisi spaziale.
AWS pubblica l’elenco delle estensioni disponibili per ogni versione del motore. Attivarle di solito richiede una sola istruzione SQL, senza riavviare l’istanza né toccare l’infrastruttura. Con pgvector, per esempio, basta collegarsi al database e lanciare CREATE EXTENSION vector;. Da quel momento le colonne vettoriali e le funzioni di ricerca per similarità si usano come qualsiasi altra funzione nativa.
Lo stesso vale per altre estensioni molto diffuse. pg_stat_statements tiene traccia delle query più lente e più eseguite, ed è ottima quando bisogna capire dove se ne va il tempo del database. TimescaleDB è pensata per le serie temporali, tipiche di sensori, log applicativi e metriche di monitoraggio. Quando valutate RDS, tenete a mente che scegliere un servizio gestito non significa rinunciare alle funzionalità avanzate del motore. Significa solo delegare ad AWS la manutenzione che gli sta intorno.
Quando conviene rispetto a un database gestito “in casa”
Gestire il database da soli (il cosiddetto “self-hosted”) non è sbagliato in assoluto, ma conviene sceglierlo con consapevolezza e non per abitudine. RDS ha senso quando:
- il team è piccolo o medio e preferisce dedicare il tempo al prodotto invece che all’infrastruttura;
- vi serve la certezza che il servizio resti attivo anche quando qualcosa va storto, senza doverla costruire da zero;
- ci sono obblighi normativi (compliance) che richiedono backup certificati e dati protetti sia quando sono salvati sia quando viaggiano in rete;
- volete far crescere il progetto in fretta, senza fermarvi a configurare nuovo hardware.
Il self-hosted torna invece sensato quando le esigenze sono molto particolari (funzionalità non disponibili su RDS, ottimizzazioni estreme, vincoli di licenza) o quando avete già un team dedicato che sa gestire database di grandi dimensioni. In quel caso il tempo investito ripaga. In tutti gli altri, il conto costi-benefici pende quasi sempre dalla parte della soluzione gestita.
Perché per molti progetti è la scelta di default
In breve: “gestito” vuol dire backup, protezione dai guasti e aggiornamenti senza pensieri, con un pannello di controllo già pronto. Il database resta comunque estensibile, con tutte le funzionalità del motore che avete scelto. E RDS conviene ogni volta che il tempo del vostro team vale più del controllo totale sull’infrastruttura. Nella maggior parte dei progetti moderni è la scelta di default, e lo diventa ancora di più man mano che il progetto cresce.