

Articolo di Giuseppe Caliendo – Full-stack Developer in AzzurroDigitale
Dopo aver visto come AWS gestisce per noi i database con RDS, il passo successivo è costruire applicazioni di intelligenza artificiale. Amazon Bedrock permette di usare, con la stessa API, modelli di fornitori diversi, senza server da gestire e pagando solo in base all’uso. In questo articolo vediamo come scegliere il modello giusto per ogni compito, come testarlo, come mantenere i dati in Europa nel rispetto del GDPR e come dare ai modelli la conoscenza della vostra azienda con RAG e Knowledge Bases.
Nella scorsa puntata abbiamo parlato di RDS e di come far gestire ad AWS la parte noiosa dei database. Una volta che i dati sono al sicuro, la domanda successiva arriva quasi subito: come ci costruisco sopra un’applicazione di intelligenza artificiale?
Nel mondo B2B quasi nessuno addestra un modello LLM proprio: i modelli di fornitori specializzati esistono già e si usano via API. Ogni fornitore ha le sue API ed è qui che entra in scena Amazon Bedrock per aiutarci.
Amazon Bedrock ci espone “un’unica interfaccia” che dà accesso, con la stessa API, a modelli di fornitori diversi: Anthropic, Meta, Mistral, Cohere, AI21, la famiglia Nova di Amazon, DeepSeek e oltre un centinaio di modelli dal Marketplace. Vediamo cosa significa nella pratica.
Un solo punto di accesso: l’applicazione chiama sempre lo stesso servizio, con la stessa autenticazione AWS (IAM), gli stessi log e gli stessi strumenti di monitoraggio, indipendentemente dal modello dietro.
Cambiare modello, nel caso più semplice, vuol dire cambiare un parametro, non riscrivere l’integrazione. Nessuna infrastruttura da gestire: niente server, niente GPU da dimensionare. Si paga in base all’uso, misurato in “token” (i frammenti di testo, grosso modo pezzi di parole, che il modello legge e scrive).
Perché ci piace: nessun modello è il migliore in tutto
Ogni modello ha i suoi punti di forza, e non è detto che il più potente sia quello giusto per ogni compito. Un esempio di come ragionare:
Classificare email o ticket in arrivo: è un compito ripetitivo e ad alto volume, dove contano velocità e costo. Di solito basta un modello piccolo ed economico.
Rispondere a domande tecniche complesse su documentazione articolata: qui il ragionamento e la capacità di seguire istruzioni lunghe giustificano un modello più grande, anche se costa di più.
Estrarre dati strutturati da documenti o generare codice: alcuni modelli sono nettamente più affidabili di altri, e conviene misurarlo invece di fidarsi del nome.
Provare prima di scegliere
Un metodo semplice che funziona nella maggior parte dei progetti:
- Raccogliete 30-50 richieste reali (anonimizzate) con la risposta che vi aspettate.
- Lanciatele su due o tre modelli diversi, cambiando solo il parametro del modello.
- Confrontate qualità, tempi di risposta e costo per richiesta.
- Scegliete modello per modello, caso d’uso per caso d’uso: nulla vieta di usare un modello leggero per lo smistamento e uno più potente per le risposte difficili.
Dati in Europa e GDPR
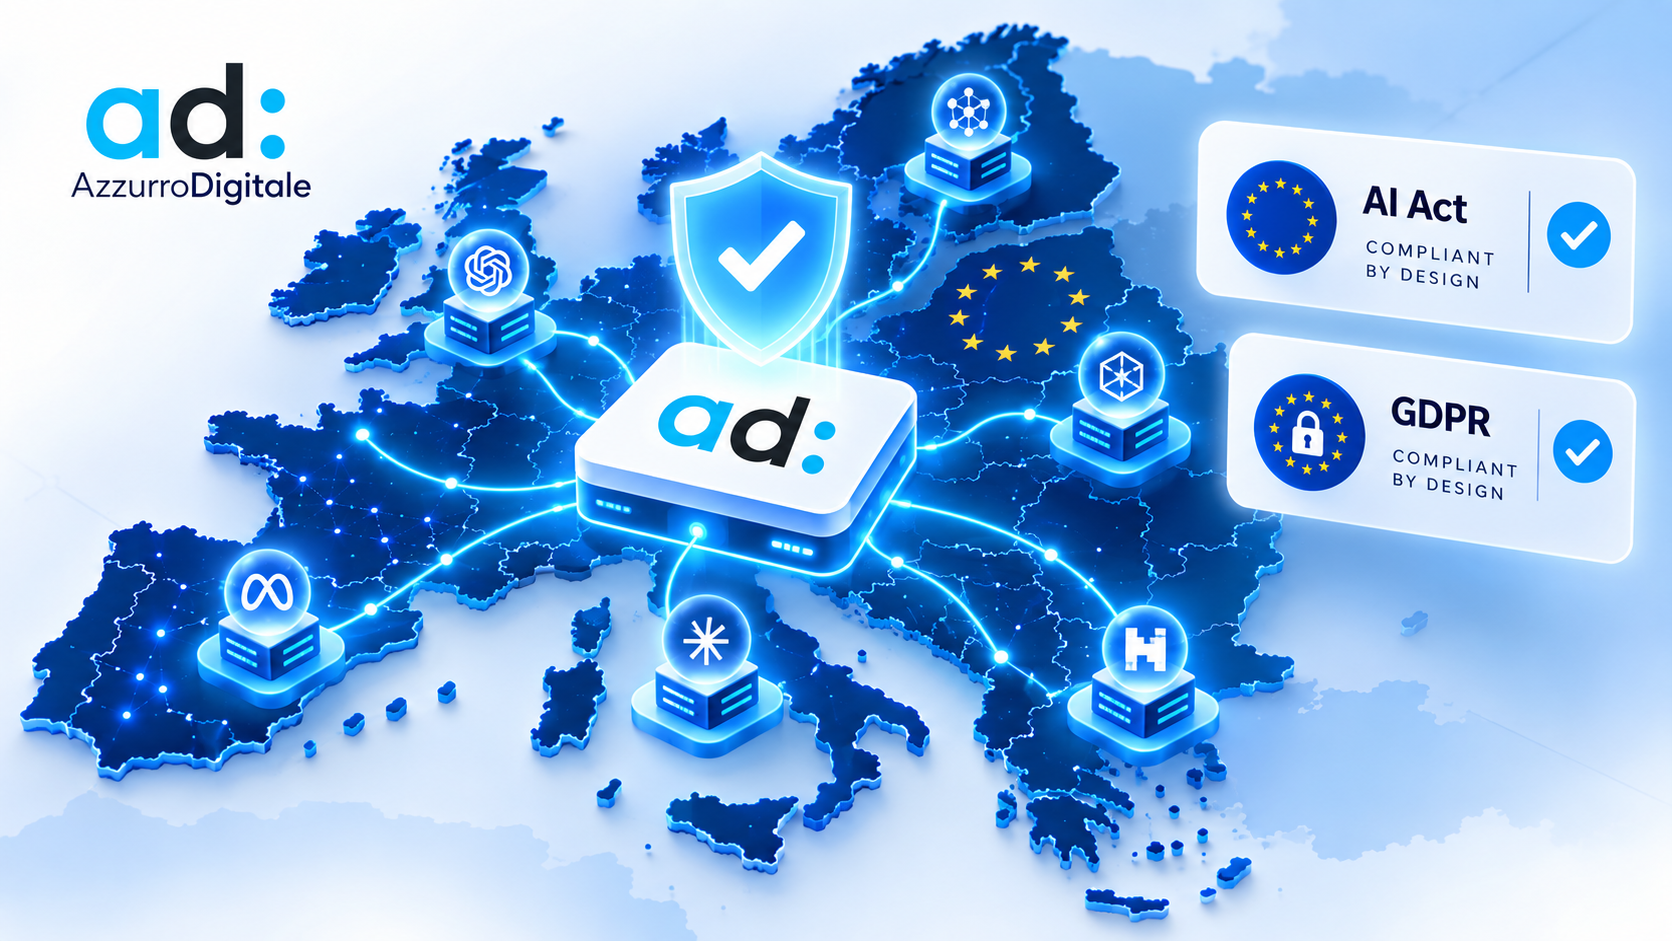
Dove finiscono i nostri dati quando li mandiamo a un modello? Con Bedrock, se configurato opportunamente, l’elaborazione resta dentro i confini europei: basta usare un profilo di inferenza EU (nel codice, il prefisso eu. davanti all’identificativo del modello), che non instrada mai le richieste fuori dall’Europa. AWS fornisce gli strumenti; la conformità al GDPR (base giuridica, informative, permessi di accesso) resta in capo a chi costruisce l’applicazione.
Dare ai modelli la conoscenza della vostra azienda: RAG e Knowledge Bases
Un modello sa molte cose in generale, ma non conosce i vostri manuali, le vostre procedure, i vostri contratti. La soluzione più diffusa si chiama RAG (Retrieval-Augmented Generation, generazione aumentata dal recupero di informazioni): il sistema cerca nei vostri documenti i passaggi pertinenti, li passa al modello insieme alla domanda, e il modello risponde basandosi su quelle fonti, che si possono anche citare.
Costruirlo da soli significa spezzare i documenti, trasformarli in “embedding” (rappresentazioni numeriche del significato del testo, che permettono di cercare per similarità e non solo per parola chiave), conservarli in un database vettoriale e tenere tutto aggiornato. Le Knowledge Bases di Bedrock gestiscono questa catena al posto vostro. Il vantaggio, per il tema di questa puntata, è che la base di conoscenza resta la stessa anche se cambiate il modello che risponde: il lavoro fatto sui documenti non si butta.
Un solo accesso, tanti modelli: l’AI giusta per ogni esigenza
Riassumendo: Bedrock dà accesso a molti modelli con un’unica interfaccia, quindi la scelta del modello diventa una decisione da testare e rivedere. In AzzurroDigitale lo abbiamo integrato nei nostri prodotti! Se vuoi conoscere meglio cosa abbiamo fatto, scrivici!